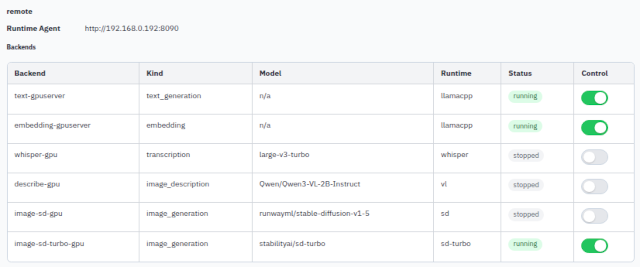
Inference Brokerは、そのバックエンドに
- llama.cppサーバー(文章生成と埋め込み生成)
- Lemonadeサーバー(NPU搭載のZIKUU Miniの場合)
- SD NPU Backend(NPU搭載のZIKUU Miniの場合、ZIKUU内製)
- GPU Inference(NVIDIA GPU搭載サーバー、ZIKUU内製)
- Vision(画像の説明)
- Stable Diffusion(画像生成)
- Whisper(音声の文字起こし)
が動いていて、文章生成、埋め込み生成、画像生成、文字起こし、画像説明を行うAPIを持っています。
文章生成については、Open AI 互換APIになっていて、/chat/completionsと/responsesの2種類が用意されており、サードパーティーのAIツールと接続できるようになっています。
Inference Runtime Agentというデーモンが、これらのバックエンドのステータス監視、起動、停止を行う仕組みがあって、Inference Brokerは、それを使って計算資源を管理します。
今回追加したスケジューラーは、GPU Inferenceが持っている、Whisper/VL/SD/SD-Turboをアプリケーションのリクエストに応じて自動的に切り替える機能です。
その際に、VRAM不足になるのは困るので、必要に応じて、VRAMに載っているモデルをアンロードして、要求されたモデルをロードするわけです。
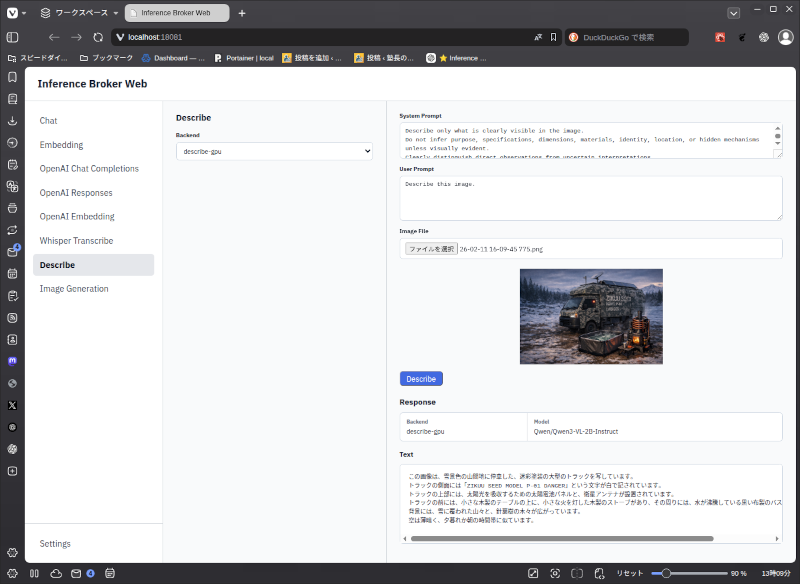
VLを使って画像の説明をさせた。
バックエンドが起動していなければ起動してから推論をします。
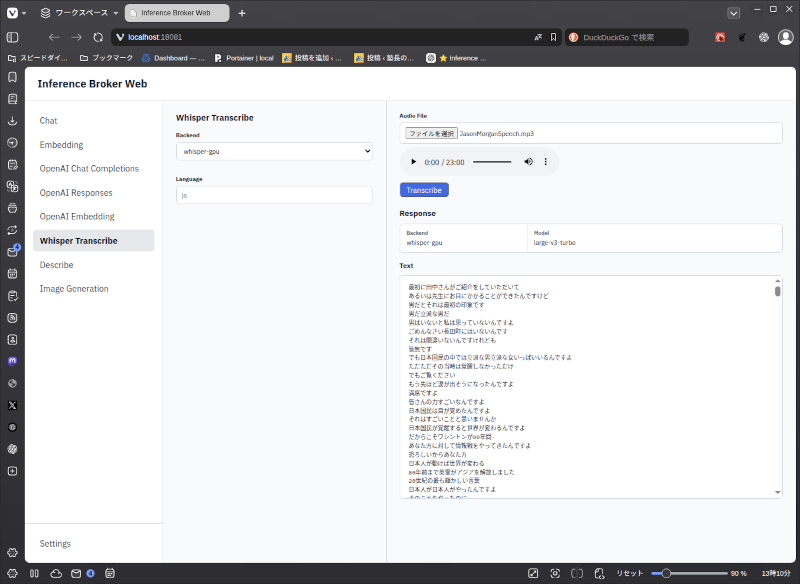
そのまま、文字起こしを実行する。
VLモデルをVRAMからアンロードして、Whisperモデルをロードして推論する。
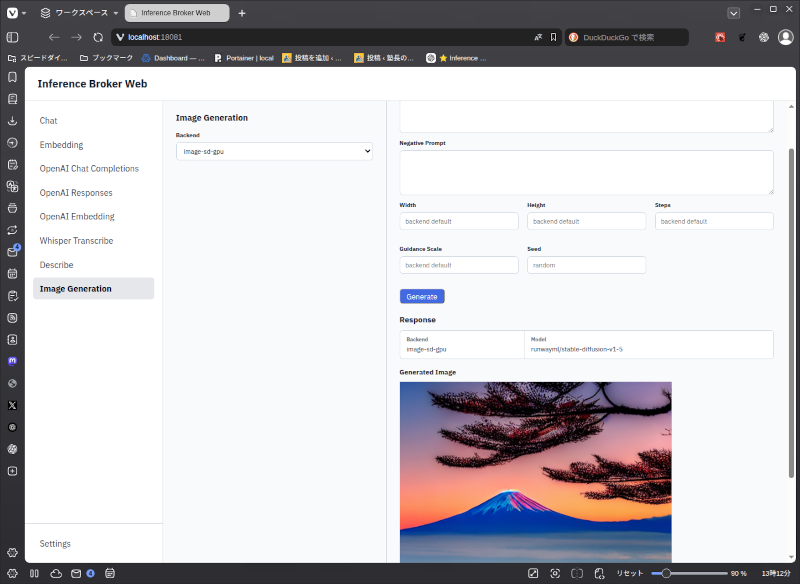
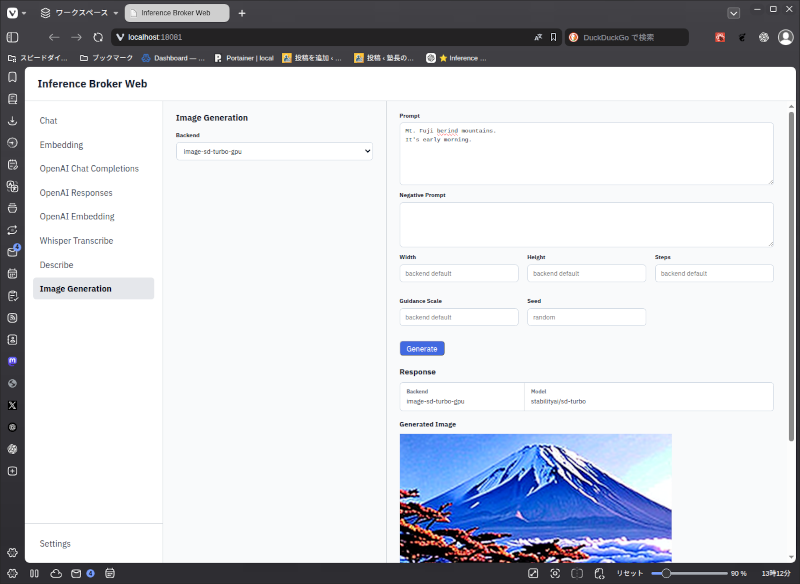
次に、Stable Diffusion 1.5を使った画像生成をさせる。
Whisperモデルをアンロードして、SD 1.5をVRAMに載せて処理する。
さらに、SD-Turboを使って画像生成する。
SD 1.5をVRAMから降ろして、SD-Turboをロードして処理する。
複数のGPUサーバーを並べれば、即時応答が必要なモデルはVRAMに載せたままにする、アクセスの頻度が高いときやサーバー障害があったときは予備のGPUサーバーも使う、急がない処理やバッチ処理では、必要に応じてモデルをVRAMに載せる、という運用設計ができます。
次は、同時にリクエストが届いたときに、キューイングする仕組みを入れようと思います。
ZIKUU Miniの場合は、これらの処理を自前のNPUとiGPUを使って行えます。
なので、GPUサーバーが忙しいときは、自前の推論資源に切り替える、空いているGPUサーバーを使うというフォールバック機能も入れたいと思っています。
これで、だいぶ推論インフラっぽくなってきました。
ZIKUUというのは、
- モノづくりのインフラ・・・工房、機械、道具、指導できる技術者
- 知識のインフラ・・・データベース、Wiki、ブログ、Discord、リポジトリ
- 思考のインフラ・・・Pivot Service、Context Pipeline Server、PRE、AI塾長
- 推論のインフラ・・・Inference Broker、Inference Runtime Agent、GPU Inference
が一体化したコミュニティーインフラの姿をしています。
つまり、
現実
↓
記録
↓
文脈
↓
思考
↓
推論
↓
再び現実へ
という循環ができる状態です。
今、こうして書いている文章(記録)も、自動的にこのループを回ります。

「Inference Broker – リソーススケジューラーを追加」への1件のフィードバック