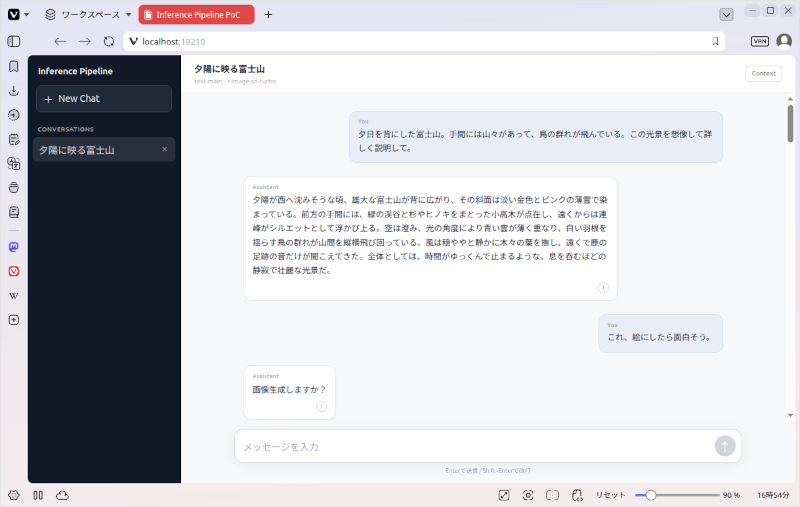
会話の中で、「画像を作りたそう」を検知して、画像生成をするかを訊いてくるようにしました。
「これ、絵にしたら面白そう。」
に対して、
「画像生成しますか?」
を返してきます。
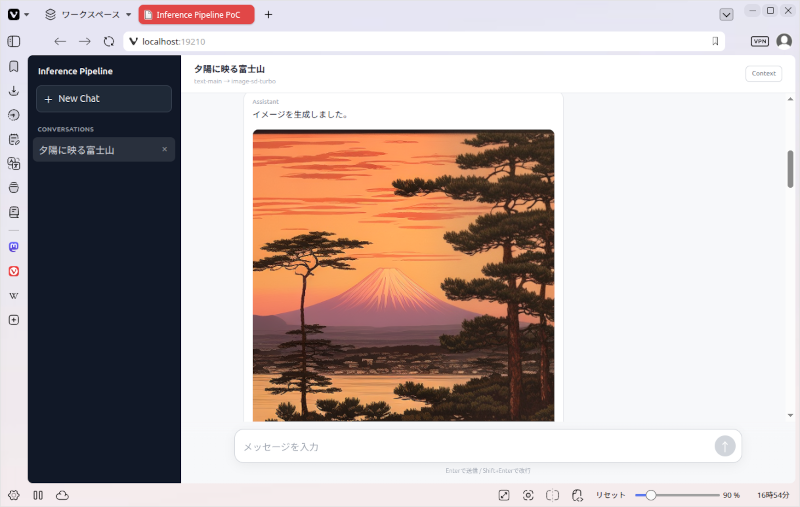
画像生成を支持すると画像を生成します。
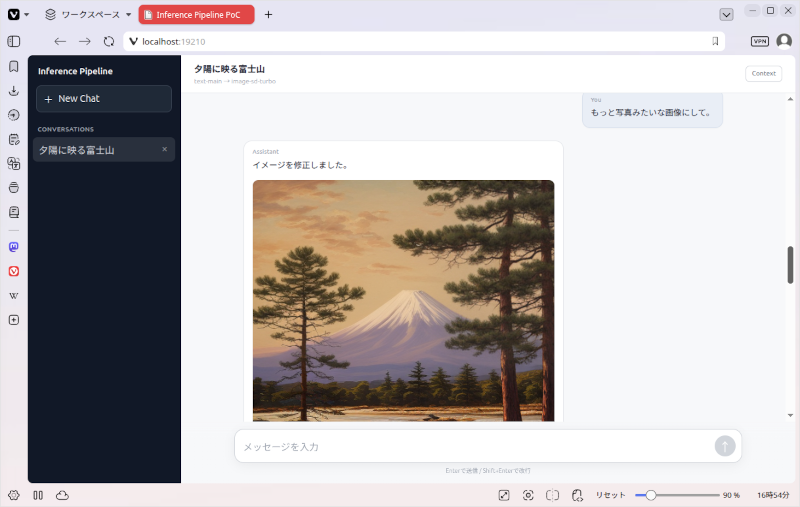
ここで、要望を追加します。
「もっと写真みたいな画像にして。」
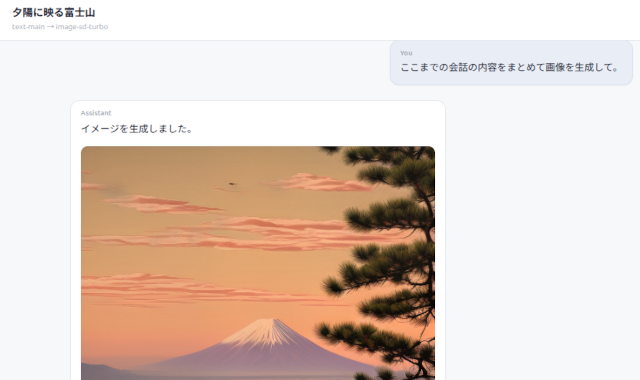
さらに、何度かやり取りをしてから、
「ここまでの会話の内容をまとめて画像を生成して。」
(会話の中に「空に鳥を飛ばせたい」などと書いてる)
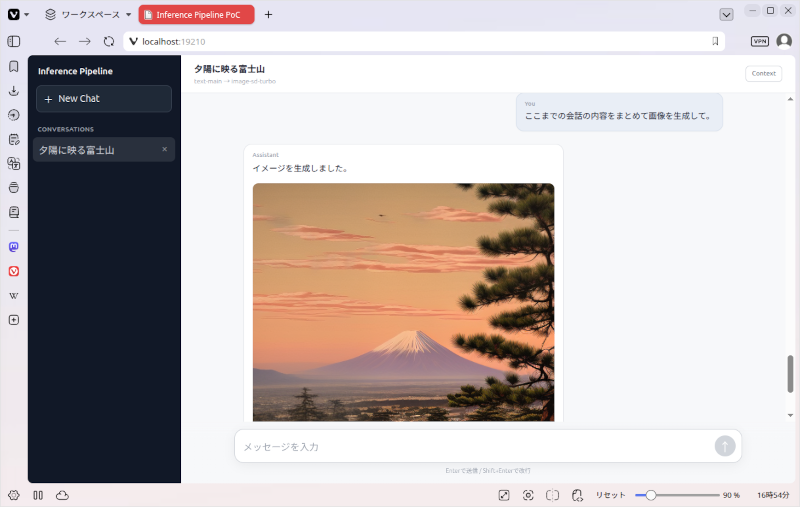
これは、毎回、画像生成プロンプトを生成しなおしているので、画像に対して、「この部分をこうして」という処理はできていません。
このPoCアプリでは、Inference Brokerの全機能をつついて鍛えるのが目的でもあります。
このアプリの場合、
User: メッセージを送信
↓
AI: メッセージから文脈を抜き出す、必要ならスレッドのタイトルを作る
↓
AI: メッセージを返信
↓
User: 画像が欲しそうなメッセージを送信
↓
AI: 画像生成するか?
↓
User: 画像生成して欲しいと回答
↓
AI: 画像生成 (ここでStable Diffusionバックエンドにリクエストを送って処理)
↓
User: 追加の要求
↓
AI: 画像生成
のような動きをします。
回答メッセージ生成
スレッドタイトル生成
文脈抽出
画像プロンプト生成
をText系バックエンドを呼び出して行い、
画像生成
をStable Diffusion系バックエンドを呼び出す。
現時点では、Text系バックエンドもStable Diffusion系バックエンドも1つですが、複数のバックエンドを用途によって選択するように作るのも簡単。
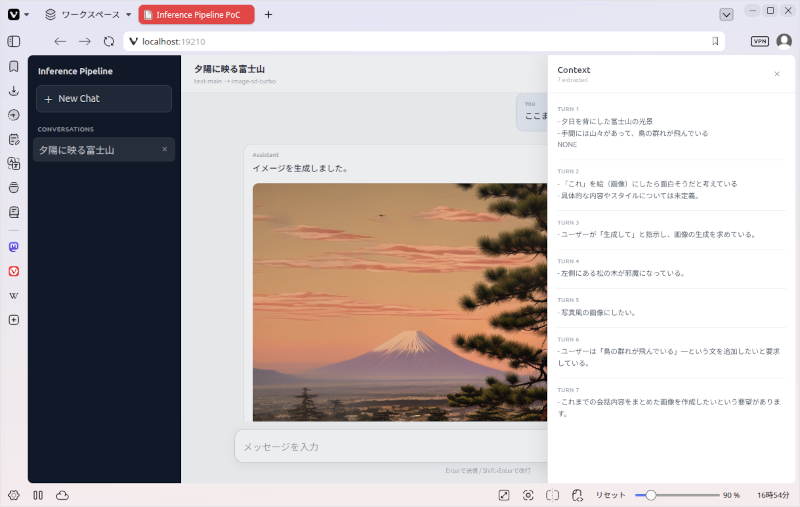
会話の各ターンの内容をそのままLLMに渡すのではなく、抽出した文脈だけを渡しています。
その文脈束も見られるようにしています。
次は、
- image-to-image、image-editみたいなバックエンドを追加する
- 画像生成モデルを増やす
- 画像の雰囲気を決めるフレーバーを選べるようにする
のような拡張をしようかな。
ZIKUUが目指しているContext Computingのために、文脈抽出だけ高速に処理できるモデルが欲しくなってきます。LLMを蒸留して軽量で高速なモデルを開発したくなってきました。

「余暇のプログラミング – Inference Pipeline PoCアプリ 対話しながら画像生成のやり直す」への1件のフィードバック