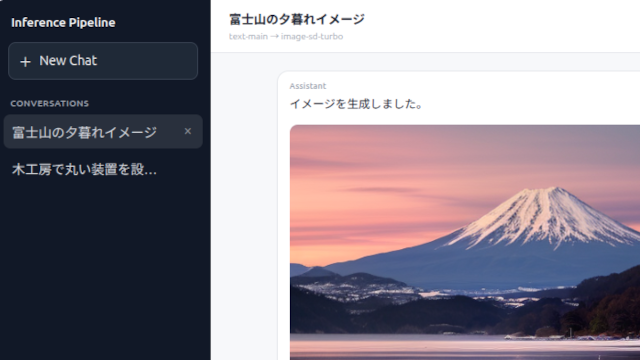
Inference Brokerの用途を広げるためのアプリを拡張して、いくつか実験をします。
前回までは、チャットスレッド全体を渡して、Stable Diffusion用のプロンプト生成をさせ、画像を生成するというものでしたが、長いスレッドでもそれらしい画像を生成できるように、スレッドメッセージをそのままLLMに渡すのではなく、1ターンごとに文脈を抽出し、スレッド内の文脈束を渡すようにしました。
これなら、状況によりますが、コンテクストウィンドウを数分の1に圧縮できるはずです。
動かした様子が下のスクリーンショットです。
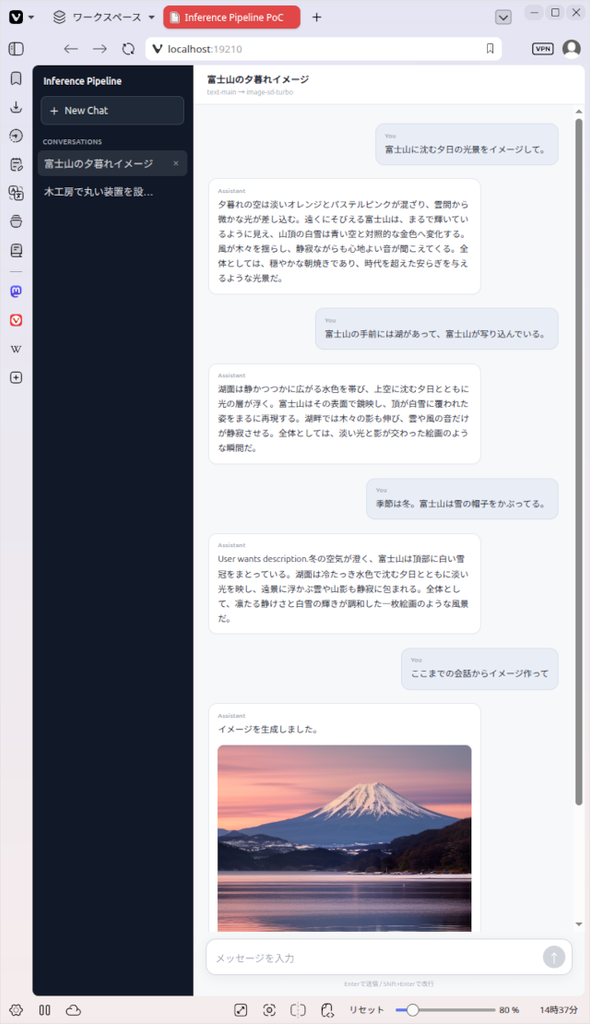
これが生成された画像生成プロンプト。
Winter sunset over Lake Kawaguchi, snowy peak of Mount Fuji reflected in the calm water, soft orange and pink sky blending into muted blue, white snow crown glistening against a pale horizon, gentle breeze rippling the surface, tranquil composition with Fuji centered above the lake.
プロンプト生成に少し問題がありますが、文脈束がプロンプト生成に影響していることは確認できました。
現時点では、スレッド内の文脈だけを参照する形ですが、他スレッドの文脈をうまく参照できるようにすると、ハイコンテクストAIチャットにできるかもしれない。
ZIKUU Mini検証機として使っている MinisforumのAI X1 Proですが、出荷状態ではVRAMへのメモリ割当が2GBです。これを16GBにして、gpt-oss:20bの4bit量子化版がVRAMに全部載るようにした結果、文章生成速度が20 token/sec 程から30 token/sec程に向上しました。
50%の高速化は大きい。
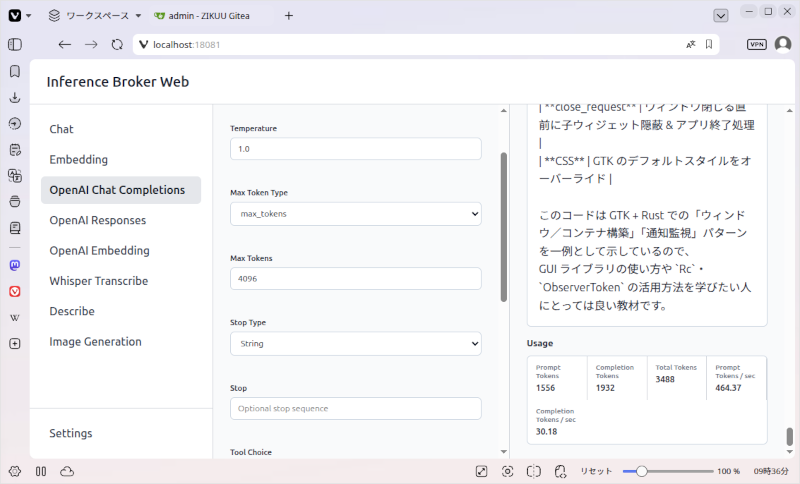
これくらいの速度が出ると、ストリーミング出力にしたチャットなら待たされる感じがしなくて快適です。
試しにQwen 3.8 27Bを、VRAMに32GB割り当てた状態で動かしてみました。
コンテクストサイズはモデルの上限256Kに設定した状態です。
動くには動きますが、生成速度は1桁token / secでした。
同じくらいの性能のMoEモデルが出たら、また試したいと思います。
この遅さは、iGPUの性能とメモリ帯域の狭さ(128Gbps)が原因でしょう。
たぶん、最も支配的なのはメモリ帯域です。
Strix HaloやDGX Sparkでも 256Gbps +程度です。
もっと広い帯域が欲しいところです。
重要なのは、計算力よりもメモリ帯域です。
1TB近いメモリ帯域と256GB以上のユニファイドメモリを搭載した省電力PC。
そういうのが欲しいです。

「余暇のプログラミング – Inference Pipeline PoCアプリをそれっぽくする」への1件のフィードバック