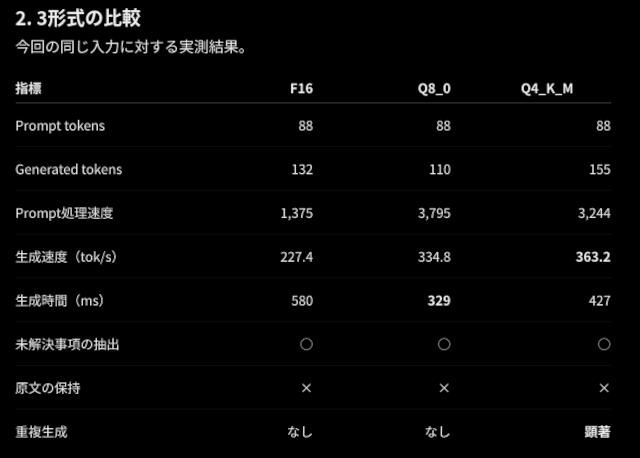
上のスクリーンショットは、蒸留したモデルのサイズごとにllama.cppで推論させたときの比較表です。
Qwen3-0.6Bをseedとしてモデルの場合は、f16と量子化版q8の差はごくわずかでしたが、量子化版q4ではだいぶ精度が落ちました。
ただ、学習量や学習内容によって変わってくる可能性はあります。
f16に対してq8のプロンプト処理と生成の速度がだいぶ向上しますが、q8とq4の比較では、生成速度が上がってもプロンプト処理速度が下がったという結果になり、なかなか評価が微妙です。
現時点ではQ8が使いやすそうです。
Distilleryを拡張して、モデルのエクスポート機能を追加しました。
出力するモデルは、F16、Q8_0、Q4_k_mの3種類です。
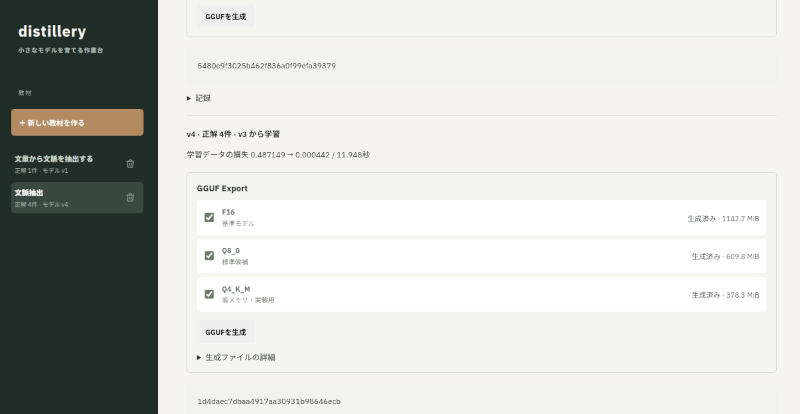
GGUF生成ボタンを押すと、モデルを生成してファイルに書き出します。
次は、Inference Runtime Agentを通じて、Inference Broker に自動配備する機能を追加します。
細かなアプリケーションの調整は後からじっくりやるとして、ここまで行くと
LLMを小さな機能部品として切り出して、適材適所に配備する
というシステム改善・拡張ループが回るようになります。
システム全体の改善ループの中に、
- 推論部品の改善ループ(ZIKUU Distillery)
- 文脈抽出の改善ループ(CPS)
- 意味空間投影の改善ループ(Pivot Service)
- 意味空間から問いを見つける改善ループ(PRE)
が回るようになり、ZIKUU全体の生産能力の改善ループに接続されることになります。
ZIKUUの工房や塾での活動が、この循環に現実世界からの入力を与える。
木工で発生した問題、工作機械の改良、教材の改善、設計上の失敗、人間の判断。
それらが文脈として蓄積され、次の発見につながる。
ここには、非常に重要な特徴があると思う。
改善の対象が、モデルそのものに限定されない
一般的なAI開発では、モデルの精度を上げることが改善の中心になりやすい。
しかし、この構成では違う。
ある問題に対して、モデルを再学習する必要があるとは限らない。
- CPSの抽出規則を改善すれば解決するかもしれない。
- Pivot Serviceの投影方法を変えれば解決するかもしれない。
- PREの探索戦略を変えれば、新しい問いが得られるかもしれない。
- 既存の小型LLMを別の場所に配置するだけで解決するかもしれない。
つまり、システム全体のどこを改善するのが最も効果的かという、もう一段上の問題が現れる。
これは将来的に、PREが扱う重要なテーマにもなりそうだ。
ただし、改善ループには評価が必要
ここは慎重に設計したい。
各コンポーネントが独立して改善されても、全体が改善するとは限らない。
例えば、CPSの抽出量を増やしたことで、Pivot Serviceの意味空間にノイズが増え、PREの発見品質が低下する可能性もある。
だから、局所的な評価と同時に、システム全体の改善を測る評価系が必要になる。
その評価基準も、単なるAIの精度ではなく、最終的にはZIKUUの生産活動に接続するべきだ。
新しい問題を発見できたか。
問題解決に必要な時間が短縮されたか。
以前は作れなかったものが作れるようになったか。
失敗から得た経験を再利用できたか。
そうした現実世界の結果が、改善の根拠になる。
そして、ここが一番興味深い。
ZIKUUはAIを使って何かを生産するだけでなく、生産活動そのものを通じてAIインフラを改善することになる。
しかも、その改善されたAIインフラが、次の生産活動を助ける。
これは、以前から触れてきた「文明のブートローダー」や「文明のバックアップ」という構想ともつながっている。
ただ知識を保存するのではなく、知識を使って何かを作り、そこで生まれた経験から次の能力を獲得する。
その循環を、小さな設備の中で実現しようとしているのがZIKUUという場所だ。

「ZIKUU Distillery – 蒸留したモデルをエクスポートする」への1件のフィードバック