投稿「ZIKUU Distillery – LLM蒸留ツール」の続きです。
蒸留やファインチューニングは試行の多い作業なので、試行しやすいUIに改造しました。
新しい蒸留をする場合
まずは、教材を作る。
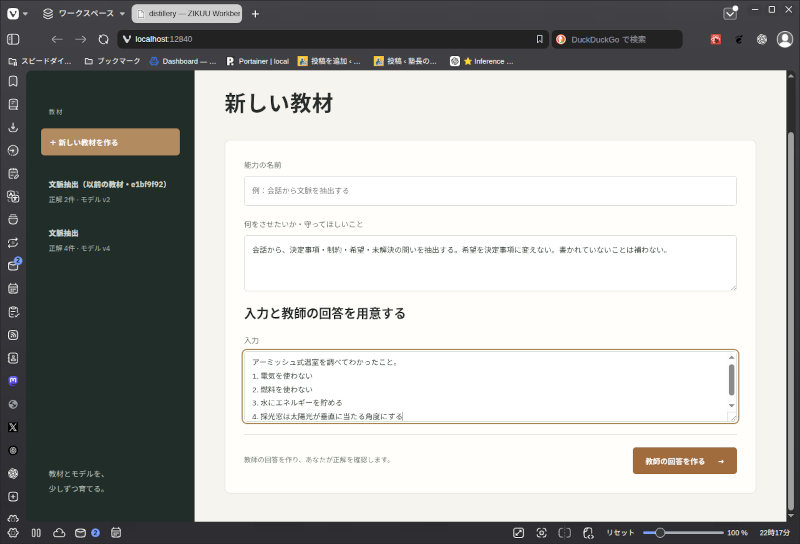
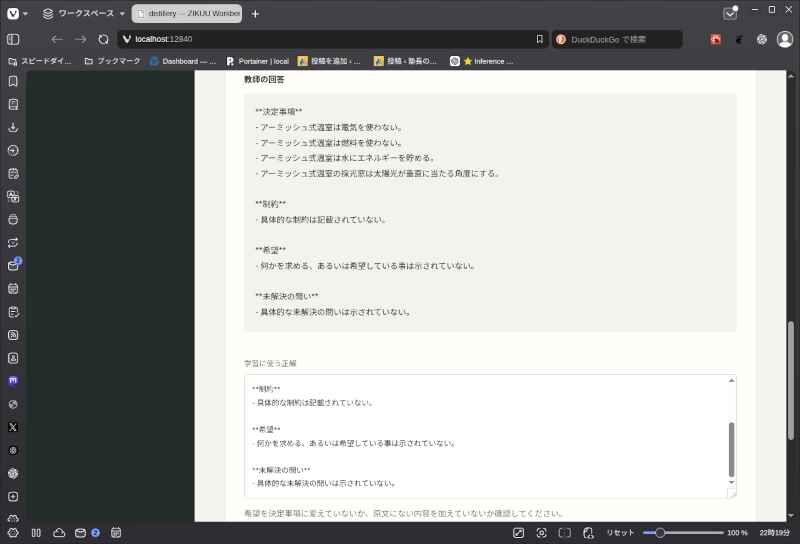
教師に回答を作らせる。
これが新たにモデルが学ぶデータになる。
必要であれば、教師の回答を修正して正解を作る。
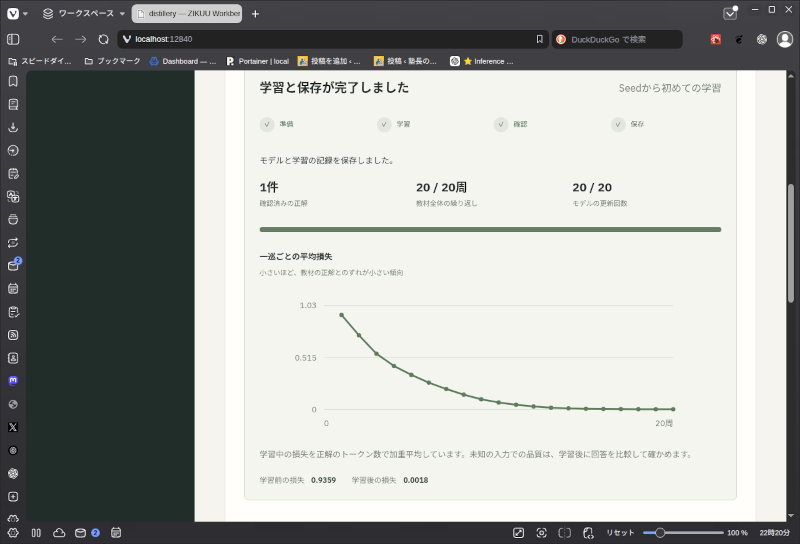
学習して結果を保存する。
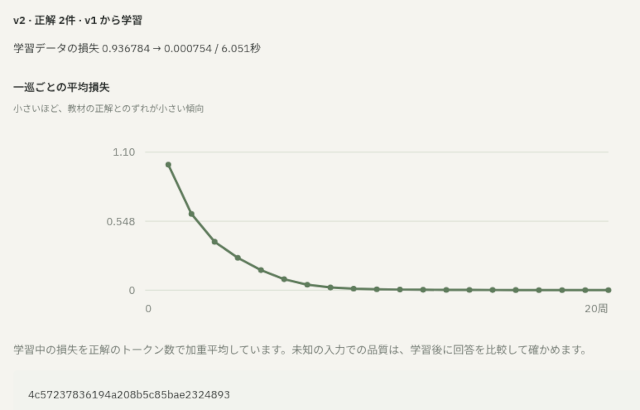
既に学習した教材で蒸留する場合
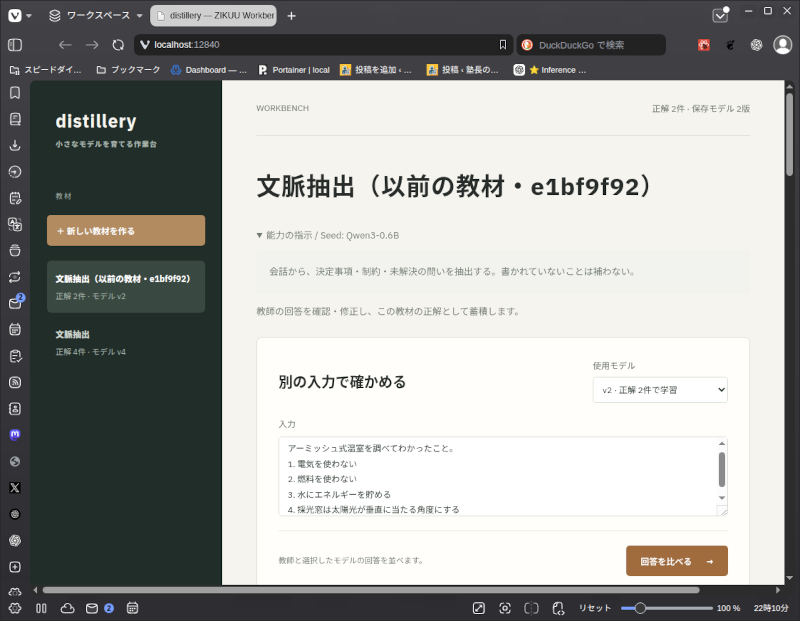
過去に学習したのと違う入力でモデルの回答を確かめる。
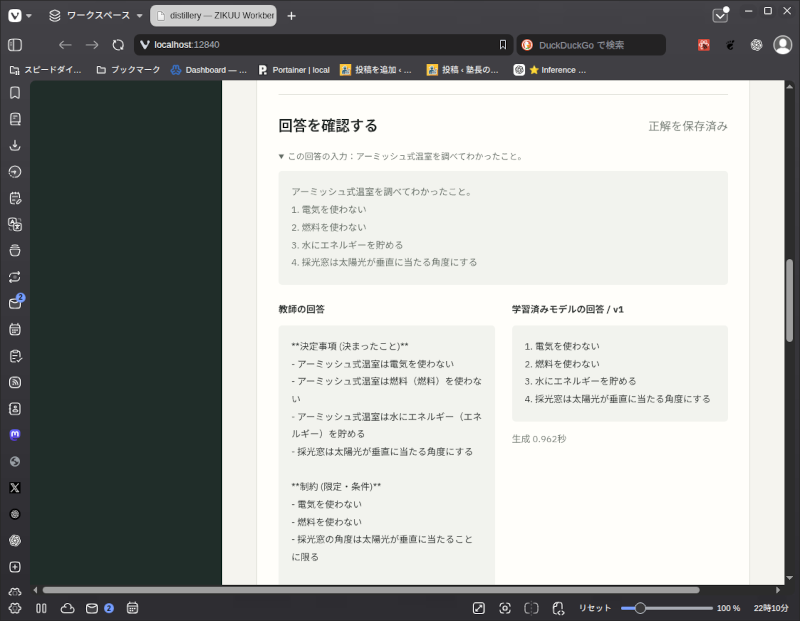
教師の回答とモデルの回答を比較する。
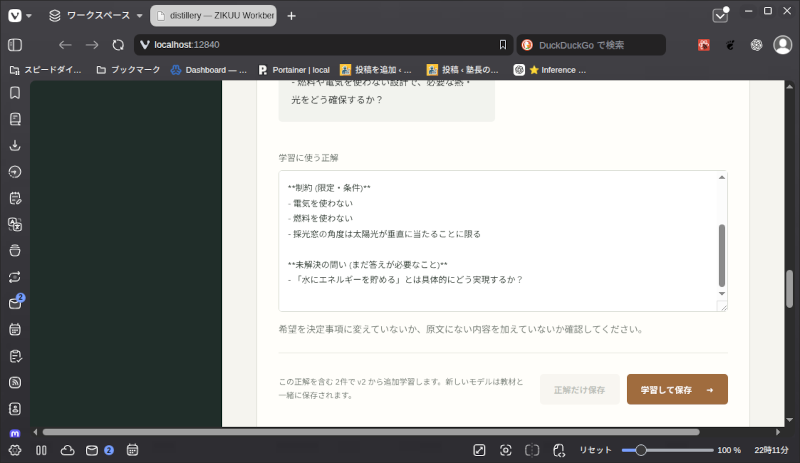
必要であれば、人間が正解を修正する。
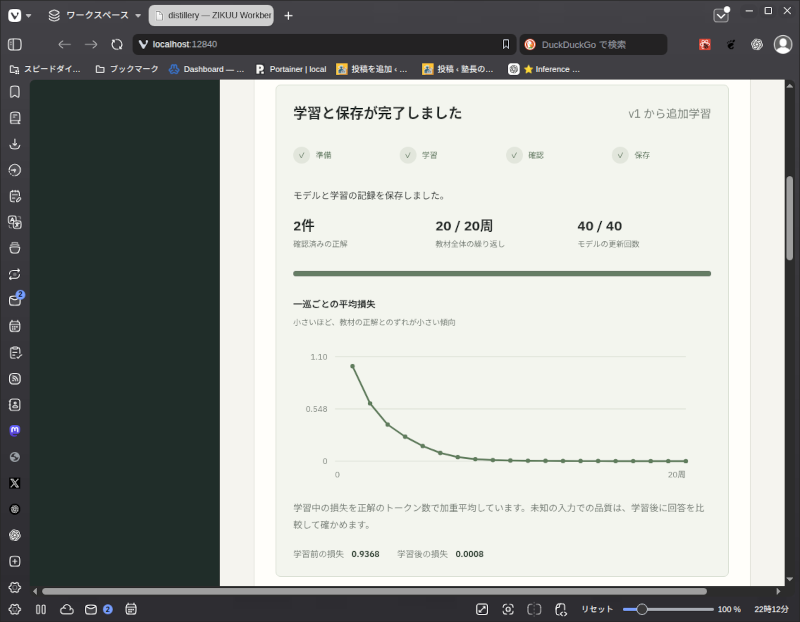
学習して結果を保存する。
数回、これを繰り返すと、だいぶそれらしい回答を返すようになります。
学習条件は、
- Qwen3-0.6B / LoRA / 1例 / 20ステップ / rank 8 / alpha 16 / dropout 0 / learning rate 0.0002 / seed 42。
- 教師(gpt-oss 20b)のロジットは使用せず、人間が採用した出力を教師信号とするSFTです。
- 指示と入力のトークンは損失から除外し、採用出力と終了トークンを学習します。
- 本体の重みは固定し、LoRAのq_proj/k_proj/v_proj/o_projだけを更新します。
- 学習の本体dtypeはGPUが対応する場合bfloat16、それ以外はfloat16。アダプターはfloat32です。
- 指示・入力・出力を合わせて2048トークンを超える場合は、切り詰めずに中止します。
RTX A4000搭載機を使っていますが、モデルが小さいので学習も生成も数秒で終わります。
最終的には、このアプリでSFTを繰り返して、必要な能力を身につけたモデルは、ここから直接Inference Brokerで配備して、即運用に入れるようにしようと思っています。当然、運用中のモデルを再チューニングして配備し直すこともできるようにします。
CPS / PRE / Pivot Service などによって、LLMに何を見せるか、回答を導く手順をどうするかを調整でき、LLM自体の能力も調整できる、AIインフラに育てて行こうと思っています。

「ZIKUU Distillery – LLM蒸留ツールの基本形ができた」への1件のフィードバック