教師モデルが生成した文章を人間が調整し、Seedモデルに学習させ、学習結果を蒸留モデルとして仕立て、Inference Broker経由で配備し、配備したモデルの検証をする。
このループが回るところまで漕ぎ着けました。
これで開発ツールとしてのZIKUU Distilleryは完成です。
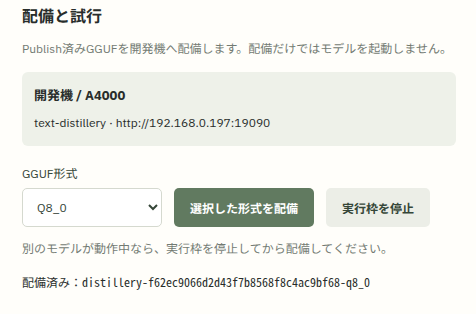
これが配備画面です。
学習したモデルを選んで、開発機のInference BrokerとInference Runtime AgentのAPIを使った配備します。
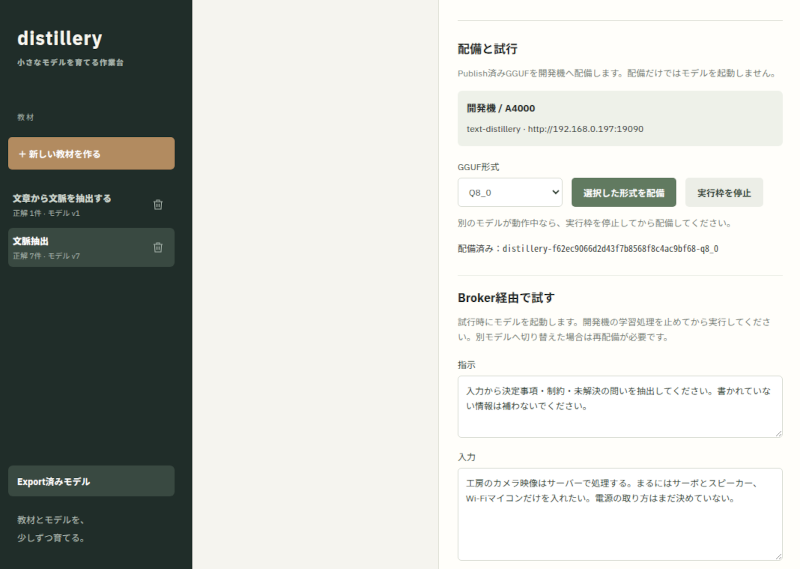
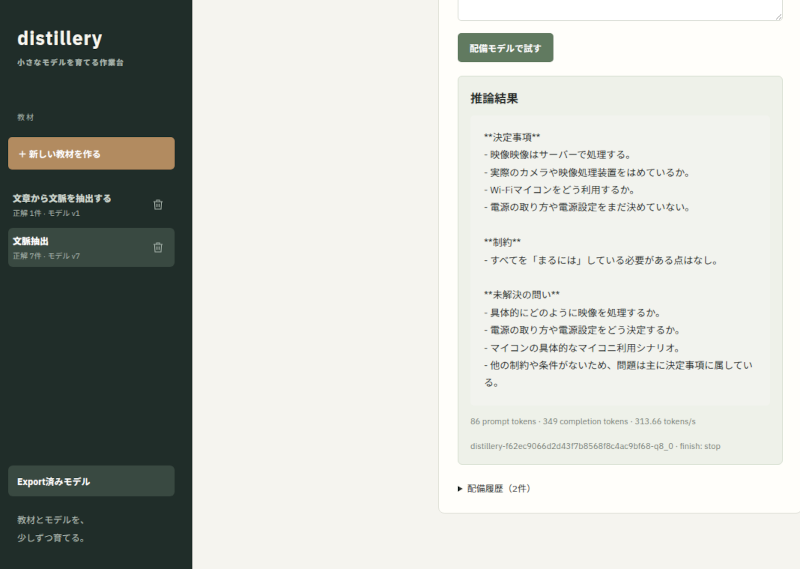
配備が完了すると、推論の検証を行う画面が出ます。
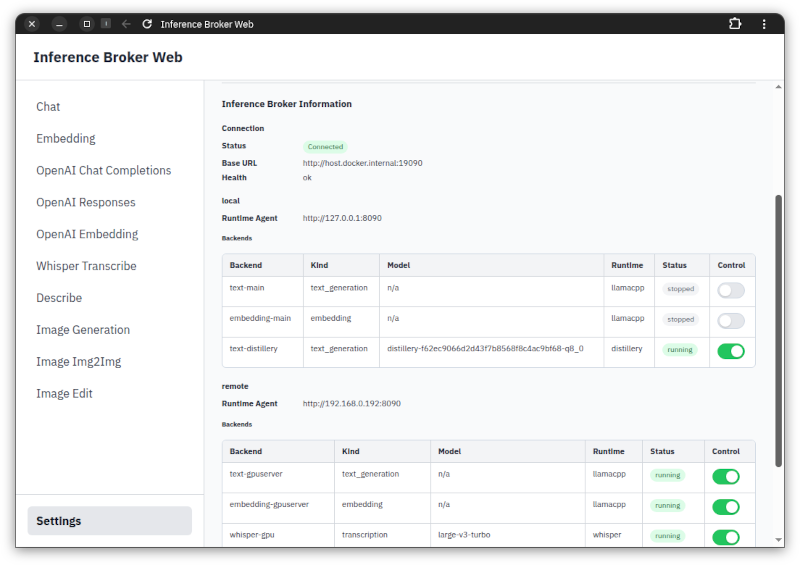
Inference BrokerとInference Runtime Agentにより、VRAM枯渇を避けるために、他の推論資源と排他制御が行われます。
localのBackendsを見ると稼働中の推論資源は text-main と embedding-main。
この状態では、VRAMに通常利用のLLMが載っています。
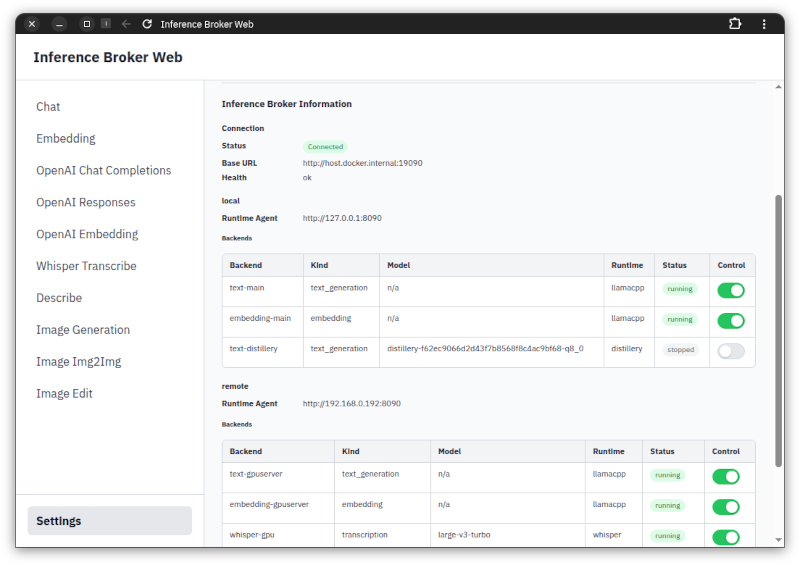
蒸留モデルにアクセスすると、VRAMに載っているモデルを降ろして、蒸留モデルを載せます。
逆もまた然り。
小さな蒸留モデルとgpt-oss 20bとの速度比較。
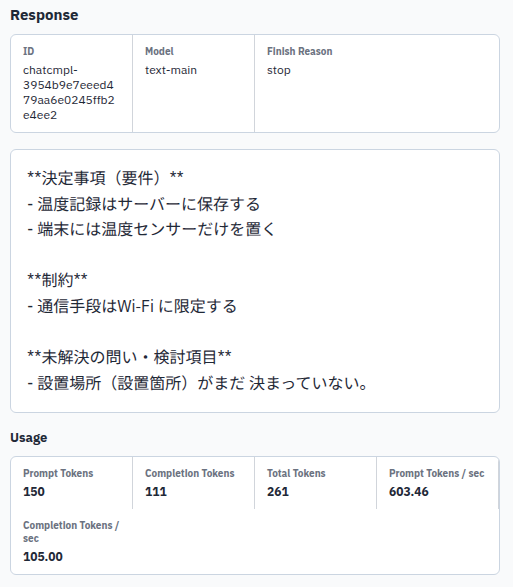
まずはgpt-oss 20bが、
プロンプト処理が 603.46 トークン/秒。
生成処理が 105 トークン/秒。
蒸留モデルの方はというと、
プロンプト処理が 4445.91 トークン/秒。
生成処理が 333.22 トークン/秒。
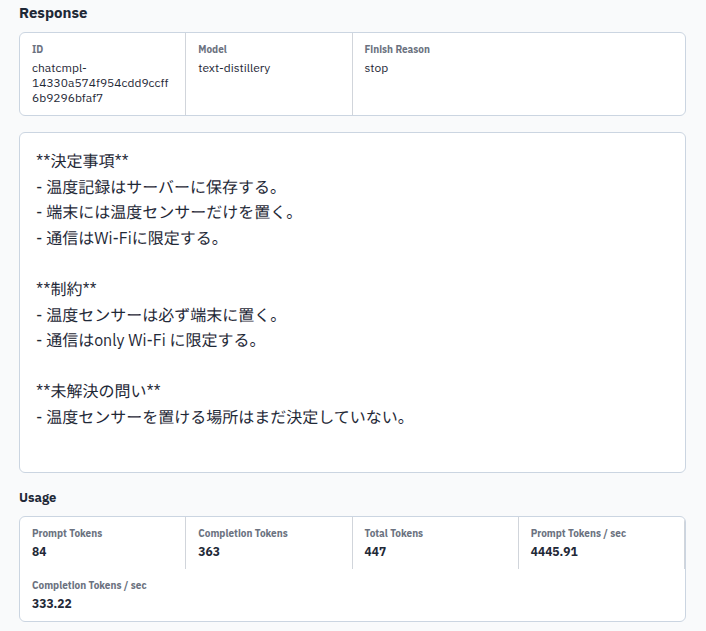
やはり小さなモデルは速い。
小さなモデルが動く小さなコンピューターを並べてLLMオーケストレーションをするとか、小規模な計算資源でAIアプリを動かす、みたいなことをするときには便利だと思います。
ZIKUUの設備では、大きなモデルをSeedにして、巨大な教師モデルを使った蒸留はできませんが、モデルが大きくても小さくても、この仕組みは動くので、掛けられる費用次第でどうにでもなります。
現時点では蒸留モデル開発ツールという位置づけですが、将来的には運用ツールの一つとしてZIKUU Miniに標準インストールされるソフトウェアになるでしょう。
