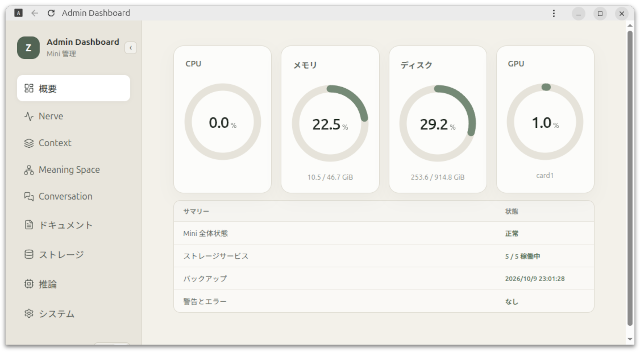
CUDA前提に開発したLLM蒸留ツール ZIKUU Distillery でしたが、AMD Strix Point (Ryzen AI9 370)搭載のZIKUU Mini機でも使えるように拡張しました。
このPCは、Ubuntu 24.04 LTSで動いており、64GBのメモリーのうち、16GBをVRAMに割り当てる設定です。
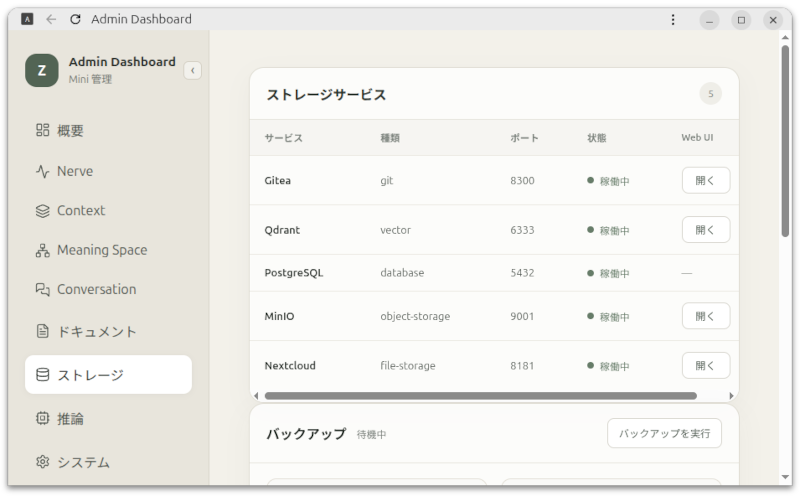
ZIKUU Miniのストレージサービスは、
- Gitea
- Qdrant
- PostgreSQL
- MinIO
- Nextcloud
を標準としています。
このうち、Distilleryでは GiteaとMinIOを使います。
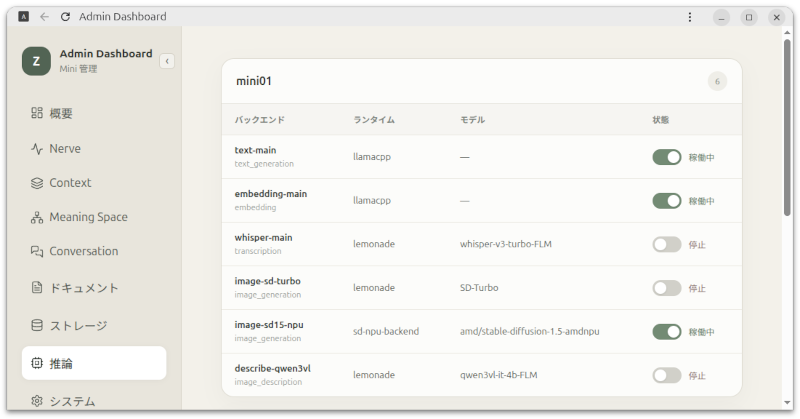
Inference Brokerにより、複数の推論資源が利用できる状態です。
このうち、text-main というバックエンドをDistilleryの教師として使用します。
このバックエンドはgpt-oss 20bを使っています。
今日やったのは、
- 教材を作る
- 典型的な入力と回答のペアを作成
- 回答は教師モデルが生成したものを、必要なら人間が修正
- Seedモデルに学習させる
- 必要なだけ繰り返す
- ファイルシステムにLoRA打プターとSeedモデルをマージしてエクスポートする
- エクスポートしたモデルを、Giteaのモデル・レジストリ(リポジトリ)に公開する
までで、
- Inference Broker経由で生成したモデルを運用環境に配備する
を実現すると完成です。(CUDA版はすでに完成しています)
Giteaは添付ファイルの置き場所をMinIOに設定してあるので、モデルの公開→MinIOにモデルファイル保存という動きをします。
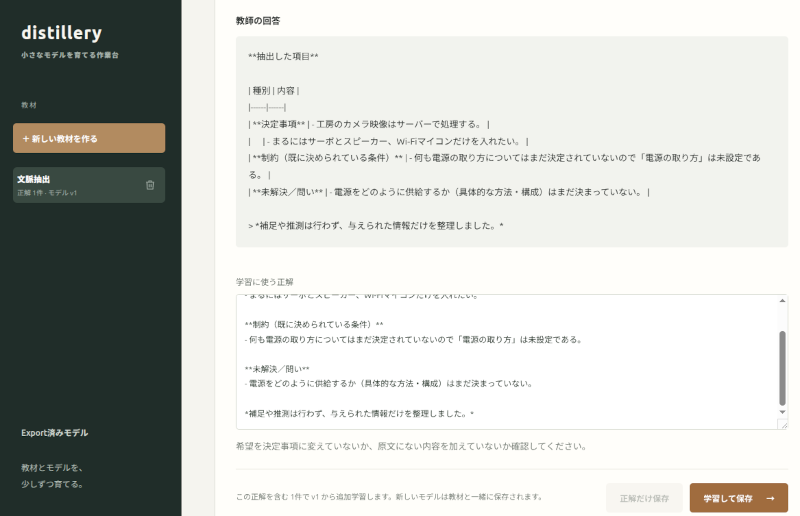
これが教材作り。
ユーザーの入力に、教師モデルが回答します。
この例では、その教師モデルの回答に人間が修正を入れています。
それがユーザーの入力に対する正解です。
これが教材。
「学習して保存」ボタンを押すと、Seedモデルに対する学習が始まります。
20ステップの学習で損失をグラフ表示します。
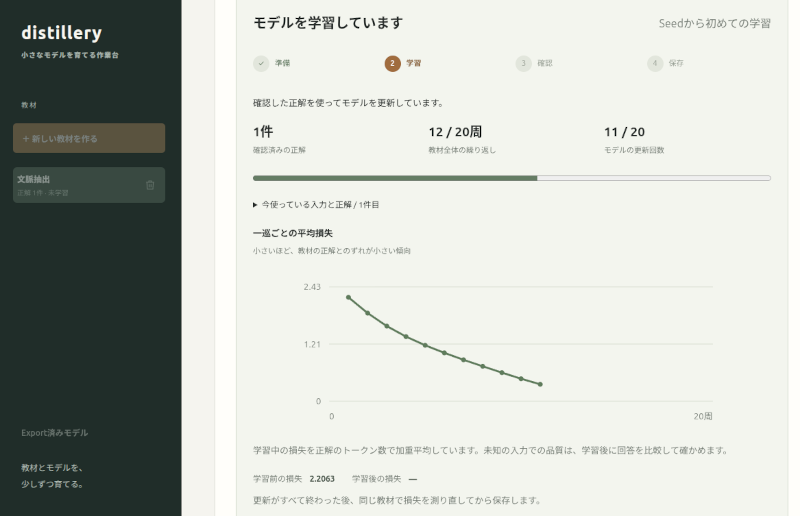
Miniの場合は、この処理に31.5秒かかりました。
NVIDIA A4000を使ったCUDA版では、同じ処理が3.6秒でした。
CUDA版と比べると遅いですが、待てない時間ではありませんし、ミニPC一台で完結するのが貴重です。
納得できる学習成果が得られるまで、上記の作業を繰り返します。
学習が終わったら、モデルファイルをエクスポートします。
エクスポートされるモデルは、F16、Q8、Q4の3種類。
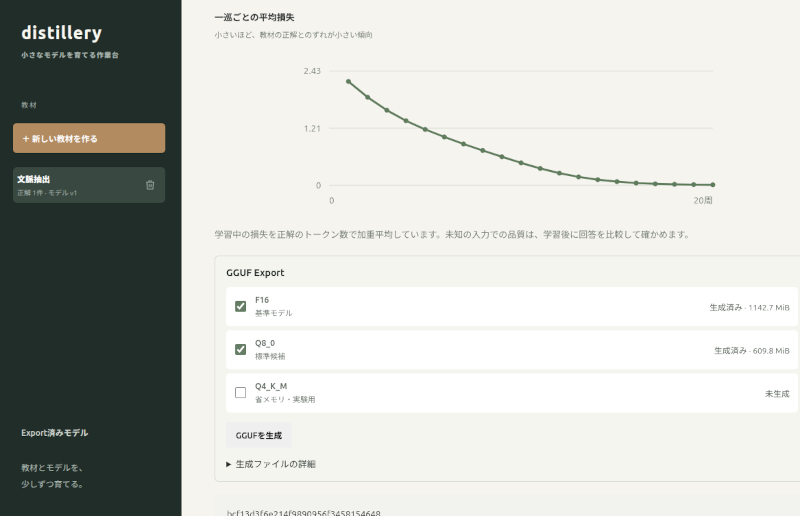
この状態で、手動でllama.cppサーバー + 蒸留済みモデルを動かせます。

「ZIKUU MiniでもDistillery」への1件のフィードバック