月曜日は休養日に当てているんですが、どうもじっとしていられない。
現在、ZIKUU Mini検証機で稼働している Inference Brokerはいくつものバックエンドを利用できるようになっています。
Miniの上だけでも、文章生成系、画像生成系、画像解析系、文字起こし系のバックエンドが揃っている。
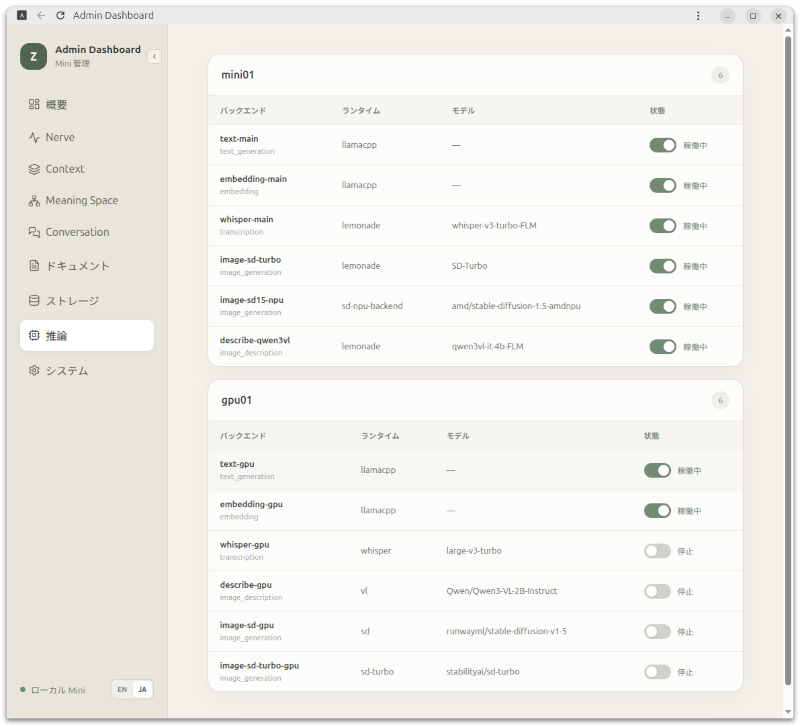
マルチモーダルなモデルがなくても、Inference Brokerがマルチモーダルなら、様々な処理ができるはず。
このInference Brokerの上に、推論パイプライン (Inference Pipeline) を作ったら面白いのではないかと思って、簡単な検証アプリを作ってみることにしました。
余暇の基礎研究という感じです。
今日は、手始めに、Text to Imageのパイプラインを作って試しました。
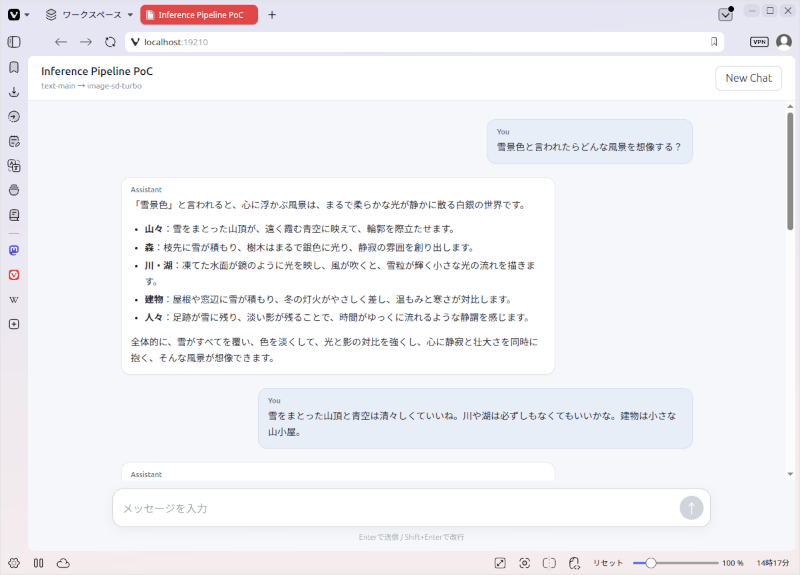
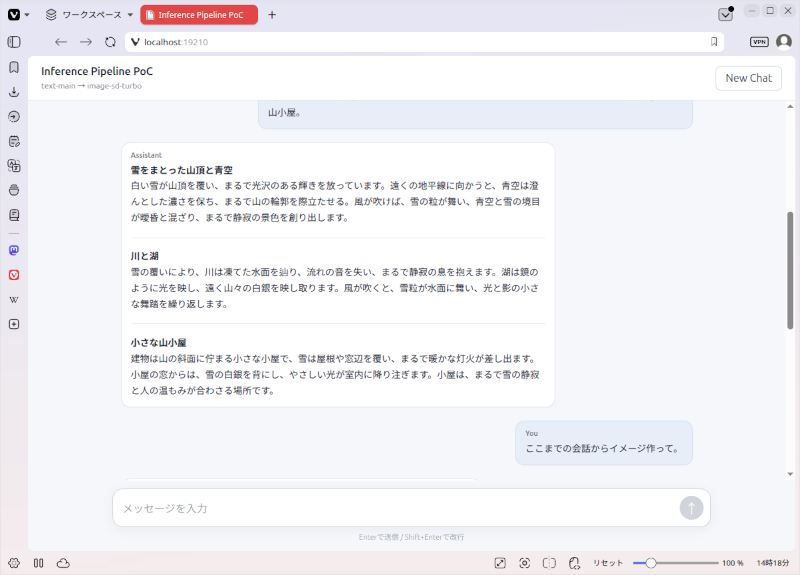
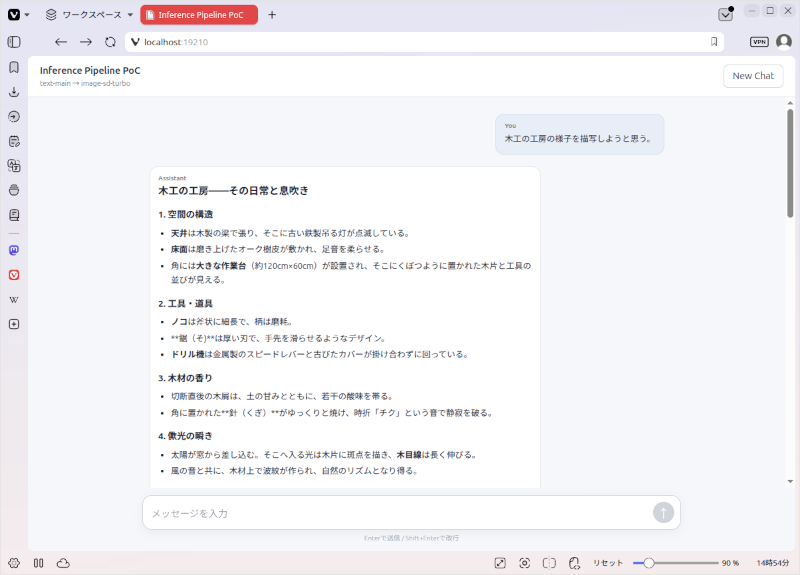
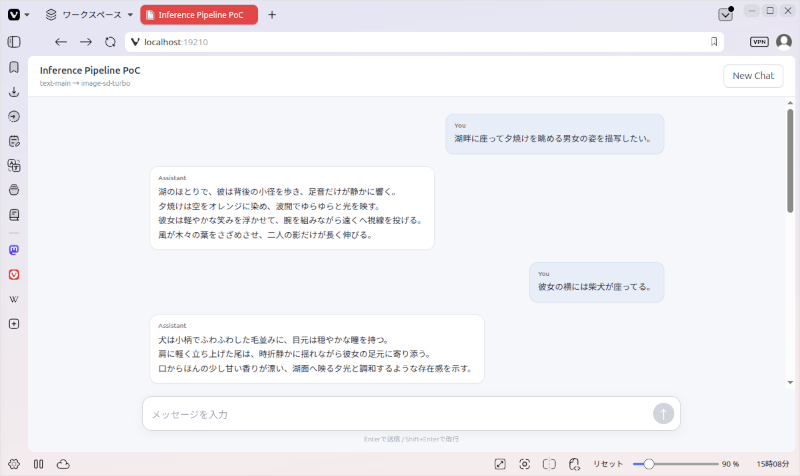
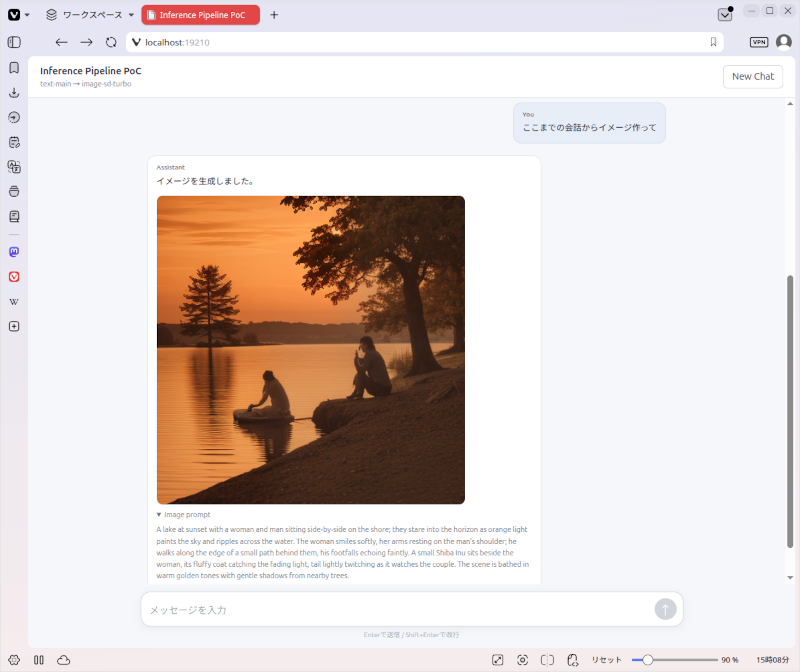
簡単なチャットアプリで、スレッド内の会話の内容を踏まえて画像生成する。
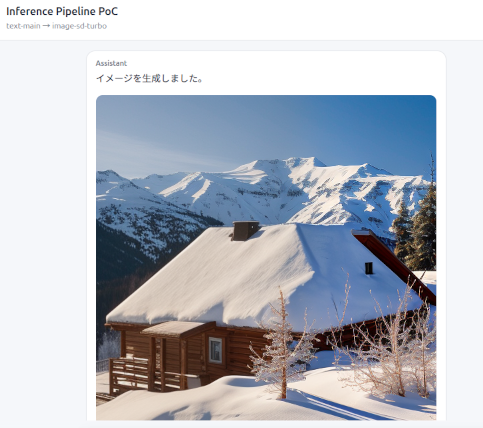
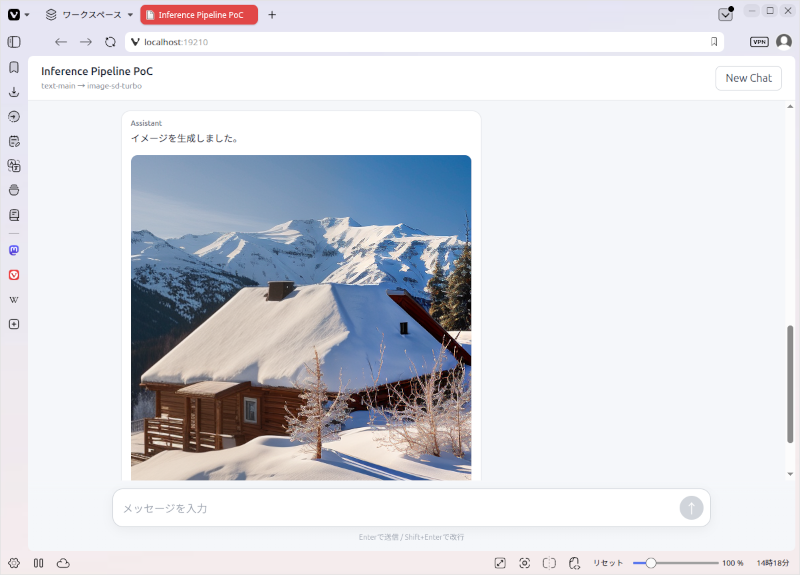
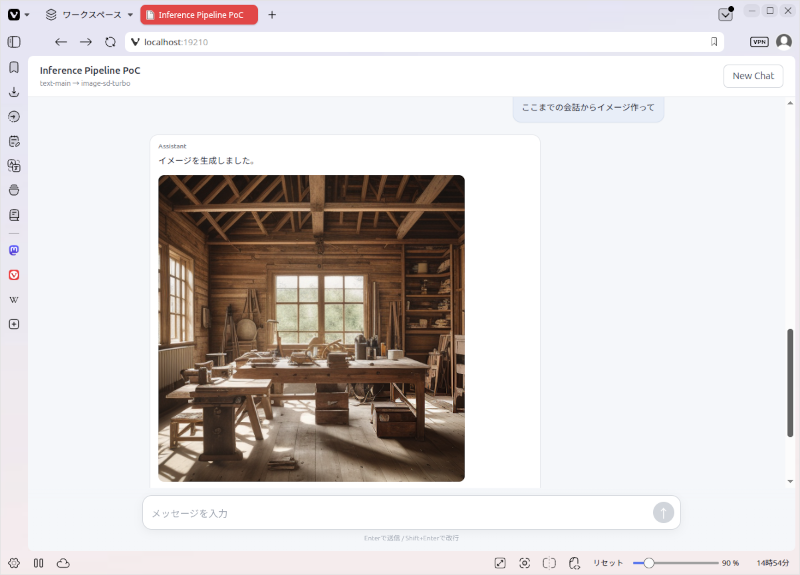
会話の途中で「ここまでの会話からイメージを作って」とすると、画像を生成します。
雪景色を描かせみた例
工房を描かせてみた例
夕焼けの景色を描かせてみた例
Stable Diffusionのプロンプト職人みたいな人が作った美しい画像を見ることもあるし、ChatGPTやGeminiなどのクラウドAIも、見事な画像を生成します。
なかなかそれらと同等というわけにはいかないかもしれませんが、もう少し煮詰めれば用途によっては活きるかなと思います。
Inference Pipelineは、
- text-to-image
- image-to-text-to-image
- audio-to-text-to-image
などの組み合わせが考えられます。
ZIKUUでは、すべてのデータをCPS (Context Pipeline Server)で文脈を抽出して蓄積しています。
その中には活動記録や技術資料の他に小説や教科書などの読み物も含まれます。
文脈自体は解釈を控えた客観的な情報ですが、使う場面、使う人によって意味が生まれます。
ここが強み。
小説の文脈を読ませて、絵本を生成し、絵本の挿絵を生成するみたいなこともやれる可能性があります。
この場合は、text-to-text-and-imageみたいなパイプラインになります。
活動記録の文脈を読ませて、小説にし、(将来は)映画を作る、みたいなこともできるかもしれません。
この場合は、text-to-text-videoみたいなパイプラインです。
論理的には成立する。

「余暇のプログラミング – Inference Brokerの用途を広げてみる」への1件のフィードバック