PRE (Pivot Reasoning Engine) はPivot Serviceが作り出す多次元意味空間をスライスした景色を見て、特徴を見つけるアプリケーションです。
内部では、Pivot を回しながら
- Sensingする
- Detectionをする
- Attentionを作る
という処理を繰り返します。
今日までに、Sensing/Detectionについては、
- Dominance
- Concentration
- Diversity
の3つを実装し、その結果としてのAttensionを作るというところまでやりました。
これがDiversity Detectorの出力。
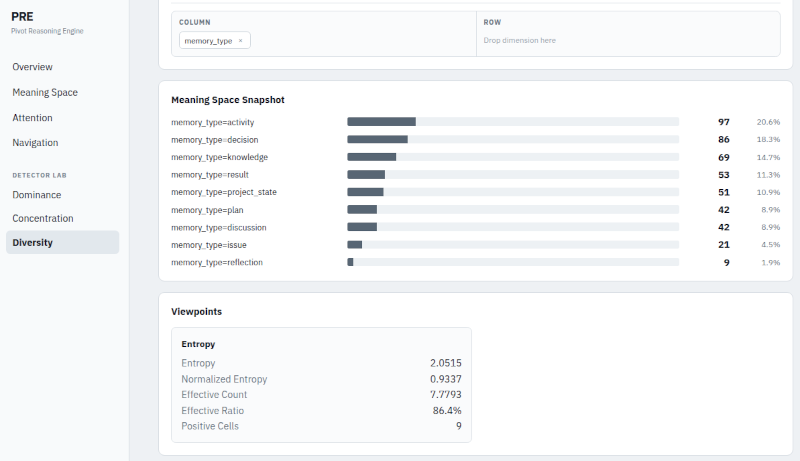
ここで見ているのは、
Entropy
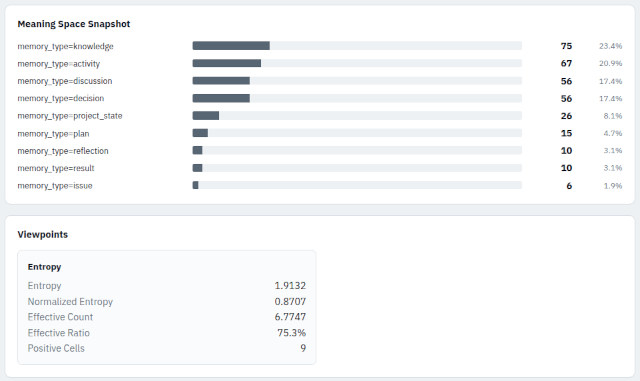
分布のばらけ具合。値が大きいほど、複数のカテゴリに広く分散している。小さいほど、一部のカテゴリに偏っている。 上の例の場合は、Entropyは小さい方。
Normalized Entropy
Entropy を、その断面で存在しているカテゴリ数に応じて 0〜1 に正規化したもの。1.0 に近ければ均等、0 に近ければかなり偏っている。
Effective Count
「実質的に何カテゴリ分くらいの多様性があるか」。
例えばカテゴリが9個存在していても、Effective Count が 1.92 なら、実際の分布としては 2カテゴリ弱くらいの多様性しかない し、Effective Count が7.78ならカテゴリ数に近い多様性があると読める。
Effective RatioEffective Count / 実際に存在するカテゴリ数。
その断面が持っているカテゴリ数に対して、実質的な多様性がどのくらい残っているかを見る。
上のスクリーンショットに出ている 86.4% なら、9カテゴリの偏りは小さい。 この数値が小さければ偏りは大きい。
Positive Cells
値が0より大きいカテゴリ数。つまり、実際に観測されたカテゴリ数。
各種Detectorを動かして得た指標を集めて、注意(Attention)を生成したのがこちら。
(上のスクリーンショットとは見ているデータが違う例)
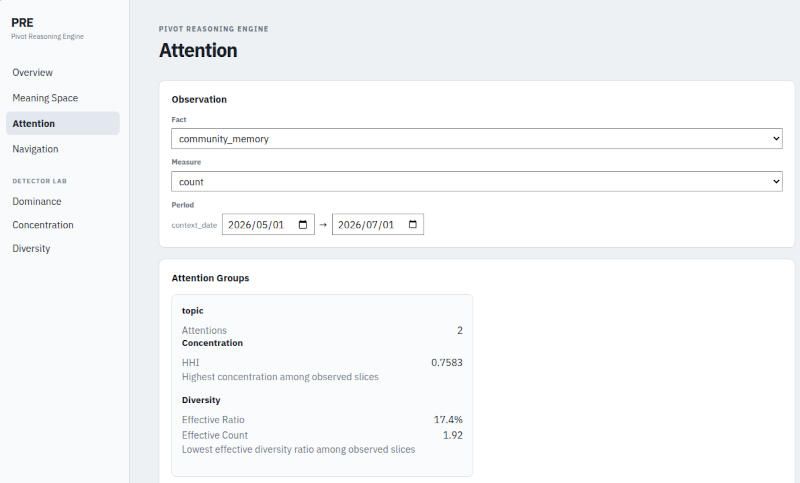
この結果をもとに、指定したFactのスナップショット(意味空間の景色)の中身を調べに行くわけです。
そこで初めてLLMが仕事をします。
つまりLLMが仕事をする前に、何を見るかを決めるのがPREというわけです。
そもそも元データから文脈を抽出している、つまりデータ量が圧縮される。
その文脈が意味空間に投影される。
その投影されたものの断面を景色として見る。
それを何度か繰り返して見つけた特徴からAttentionを作る。
それをLLMが見る。
必要なら、意味空間→文脈束→原本と辿っていく。
そういう探索システムです。
これはLLMに当てずっぽうの推論をさせない仕組みでもあります。
