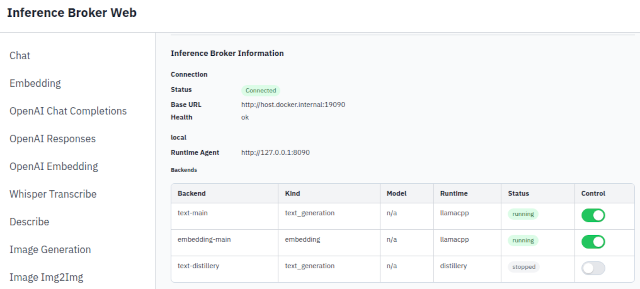
バックグラウンド系の推論処理や画像系処理に使っているGPUサーバー(dGPUを2枚搭載)の他に、対話系推論処理で使うGPUサーバーを用意しました。
VRAMの大きなGPUを入手するまでの暫定措置なので、2台目のサーバーのGPUはとりあえず動くRTX 3060 12GBと非力です。
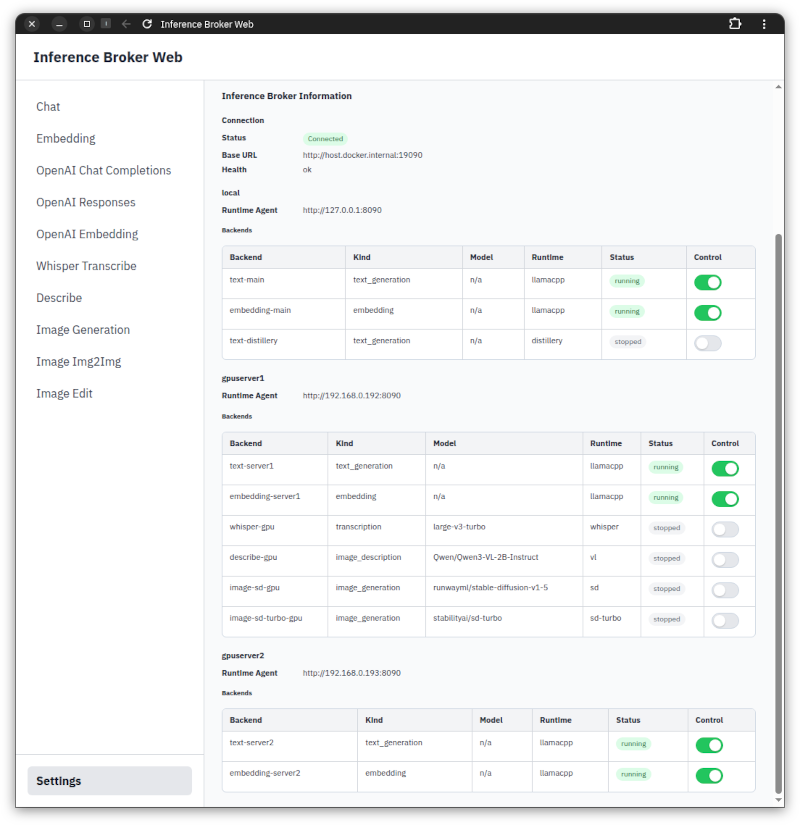
下のスクリーンショットは開発機のInference Broker UIですが、gpuserver1がこれまで稼働させていた1台目のGPUサーバーで、gpuserver2が今日追加したGPUサーバーです。
対話系推論処理は、AI塾長、PRE、Repository Explorerなどで行います。KVキャッシュを大きく取りたいので、できるだけVRAM容量の大きなGPUを手に入れたいと思っています。
かといって、常時稼働させるサーバーなので、あまり消費電力の大きなGPUは避けたいところ。
CUDAコア数や計算速度よりVRAM容量が優先です。
RTX 3060に24GBくらいのVRAMが載っていればいいのにっていつも思います。
3060でもllama.cpp + gpt-oss:20b Q4でトークン生成速度は100tps超え、プロンプト処理は300tps超えです。今のところは、性能的に、これくらいで十分。
