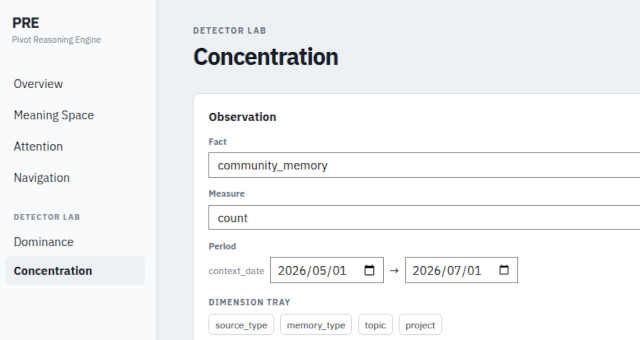
先日、最初のDetectorとして、Dominance Detectorを実装しました。
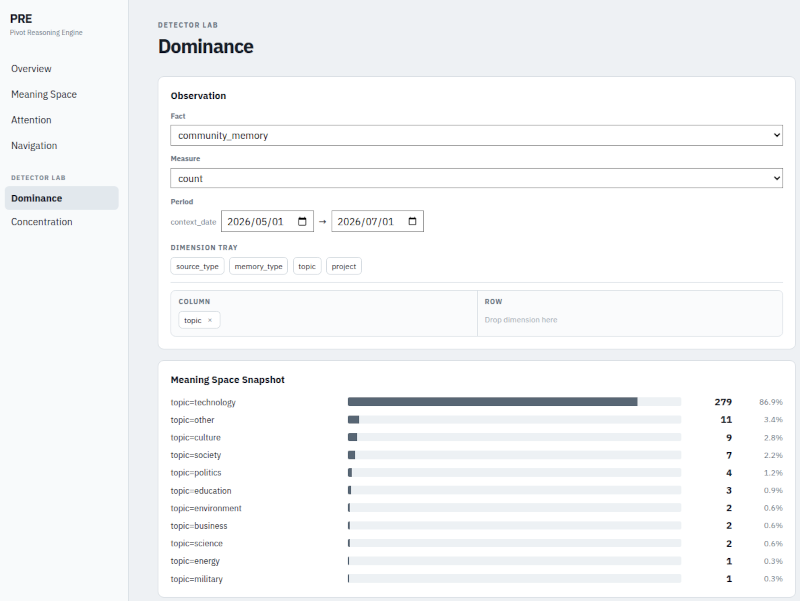
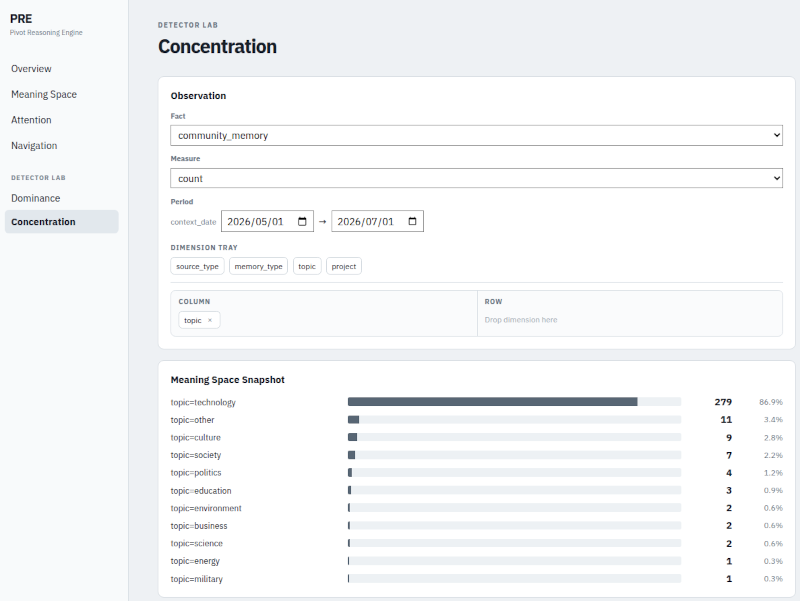
今日は2つめの Concentration Detectorを実装しました。
Concentration Detectorは、Pivot Serviceが提供する意味空間の断面から集中を検知します。
すべてのデータは、ZIKUUのシステムに入ると、
原本保存 (Gitea) → 文脈抽出 (CPS) → 意味空間投影 (Pivot Service)
が行われます。
このフローは、左から右へは再生成可能、右から左方向へは参照可能です。
これらはデータベースに正規化されていて、そこから読み込んだデータは統一した形式になので、このように視点を変えて分析することが容易です。
PREは、意味空間の特徴を検知 (Detector)して、それぞれのシグナルについて注意換気 (Attention) を生成します。
Detectorの部分は決定論的に処理可能なのでLLMを使いません。
Attention部分でもほぼLLMを使わずに実装できそうです。
その後で、仮説を立てる、問題を分類する、解釈を加えるといった段階でLLMを使うことになりますが、LLMが受け取るデータは、圧縮された数値モデル化されたものになるため、プロンプト処理を非常に軽くできます。
AI塾長の背後でこういう処理がしれっと動くところがZIKUUシステムの面白いところです。

「PRE – Concentration Detectorの実装」への1件のフィードバック