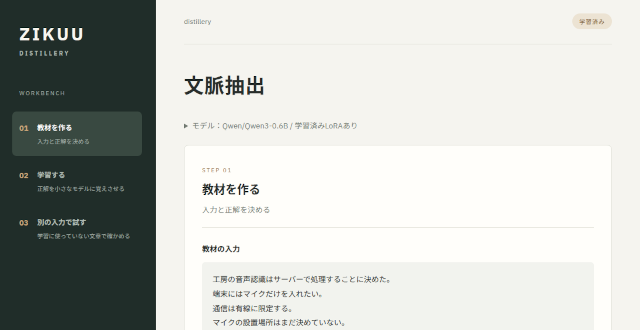
Inference Brokerを作ったことによって、LLMを「特定の能力を持った推論資源」として扱えるようになりました。
これまで、LLMは大きくて賢いものを使うのが良い、そのためには大きなVRAM、高速なGPUが必要だ、というのが一般的だったと思いますが、そういう考え方は、一旦脇に置いて、必要な推論資源を、必要なところに置くという発想に切り替えました。
この発想になると、次はこう考えることになります。
必要な推論資源は何か?
必要十分な推論能力を小さく配備できないか?
そこで、開発を始めたのが、ZIKUU Distillery。
LLMの蒸留所です。
機能は、
- 小さなLLMをSeed (種)にして、大きなLLMを教師とする
- 入力に対する教師の出力を、Seedに学習させる
- 学習した結果を試す
という最低限のものをまずは作ります。
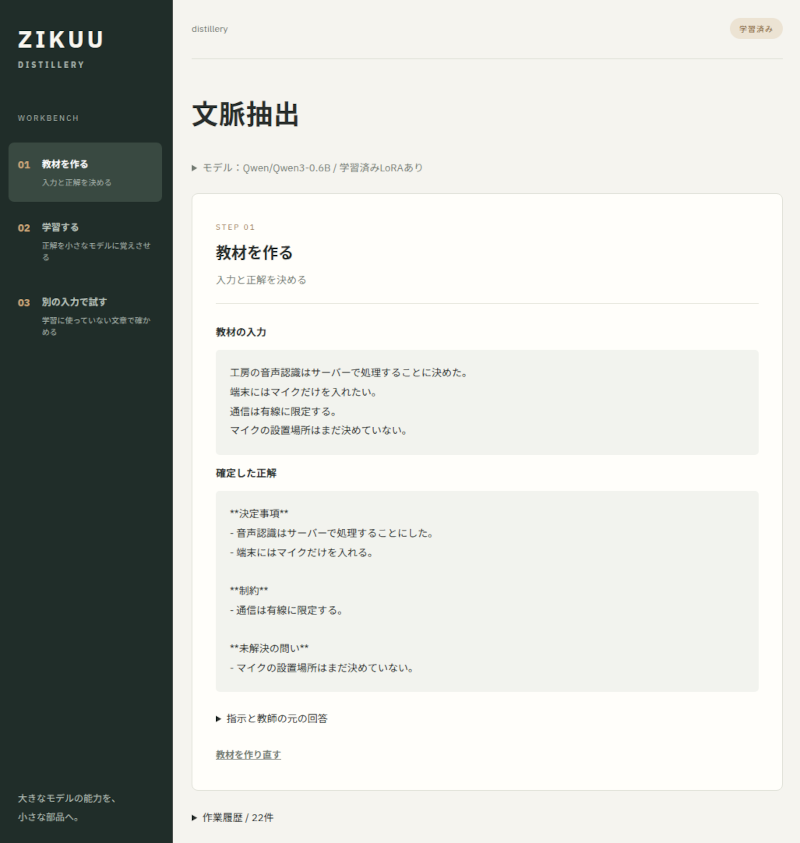
ステップ1はSeedに対する教材を作り。
入力に対する教師の回答する。
必要なら、その回答を人間が編集する。
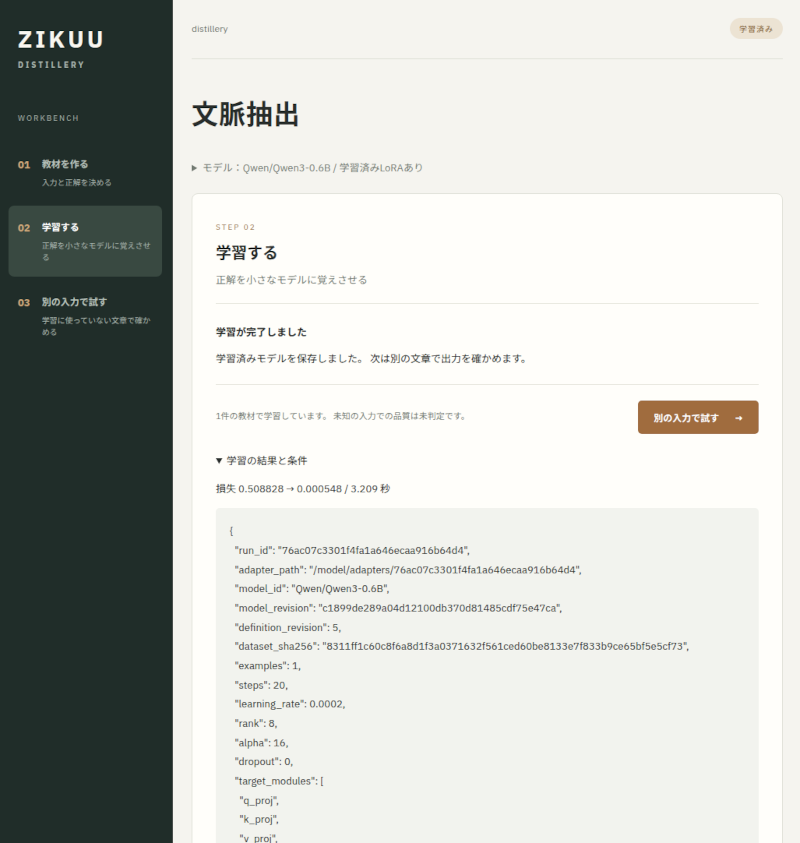
Step2は学習。
Seedモデルに学習させる。
学習結果はLoRAアダプターとして保存する。
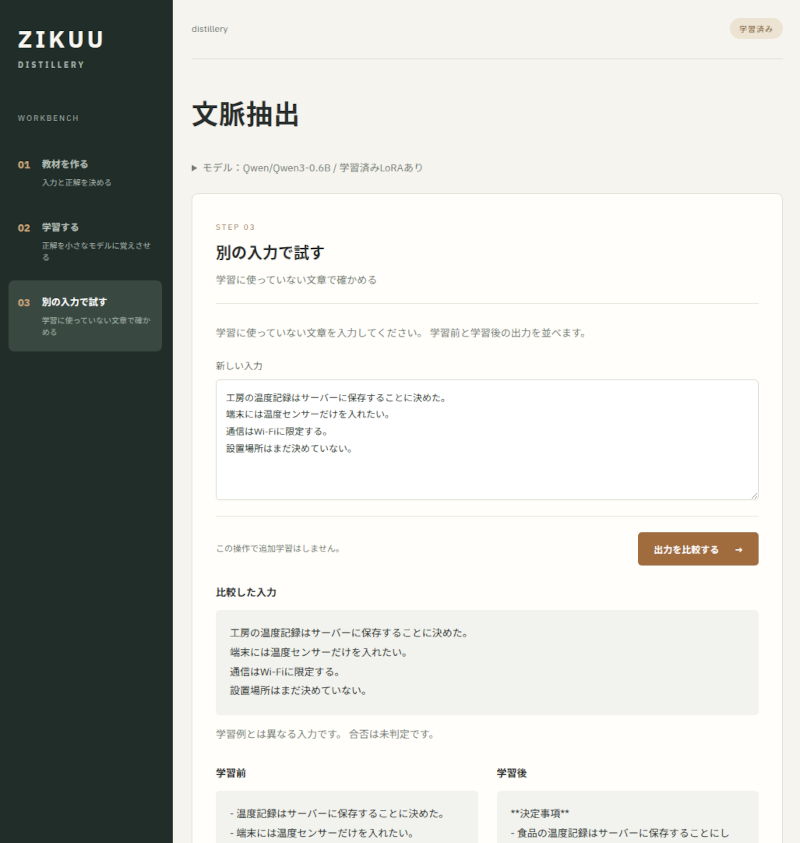
Step3は検証。
Step2で保存したアダプターを使って、別の入力で推論結果を確認する。
この3つのステップを繰り返します。
最終的に、良い結果が得られたら、モデルとアダプターを一つにまとめて、Inference Brokerに配備できるようにする。
すでにAIが考えるための基盤=AI Harnessはほぼ完成しているから、これからは、それに加えて推論部品をいくつでも作れるようにしようという考えです。
例えば、CPSが実行している、原本からの文脈抽出。
それに特化して小さくて速いモデルを作れれば、CPSの処理を高速化できます。
例えば、ユーザーの移行 (User Intent)を高速に分類できるモデルを作れば、あらゆるアプリケーションの入口で、ユーザーが何を望んでいるかを推論できます。
例えば、ワークフローに特化したモデルを作れば、AI駆動のワークフローエンジンを作れるかもしれない。
例えば、Jetson Orin Nanoのような小さな推論ハードウェアでオーケストレーションがしやすい。
もともとZIKUUでは、LLMは主役ではなく部品でしかない、という考え方なので、その考えが一層徹底されることになります。

「ZIKUU Distillery – LLM蒸留ツール」への1件のフィードバック